


从标卡底座到液冷超节点,昆仑技术亮相HPC & CGC 展会
随着大模型参数量不断提升,客户对算力基础设施的关注,正从单机性能延伸到多节点协同计算。近日,昆仑技术在深圳举办的 CCF HPC China 2026 及 2026 全球计算大会(CGC2026)相关展览中,展出了基于鲲鹏与昇腾生态打造的重磅智算双星,KunLun G6580 V3 AI服务器与KunLunPoD for AI 液冷超节点。两款产品分别面向传统机房升级与超大参数模型训练和推理场景,为客户建设 AI 基础设施提供不同选择。
KunLun G6580 V3:面向多元算力的风冷标卡服务器
在当前 AI 算力多样化发展的趋势下,客户日益关注基础设施的“兼容迭代”与“灵活部署”。KunLun G6580 V3 正是昆仑技术倾力打造的新一代 8U 旗舰风冷智算服务器。凭借强悍的性能与极高的架构灵活性,已成为企业级AI场景极具竞争力的选择。
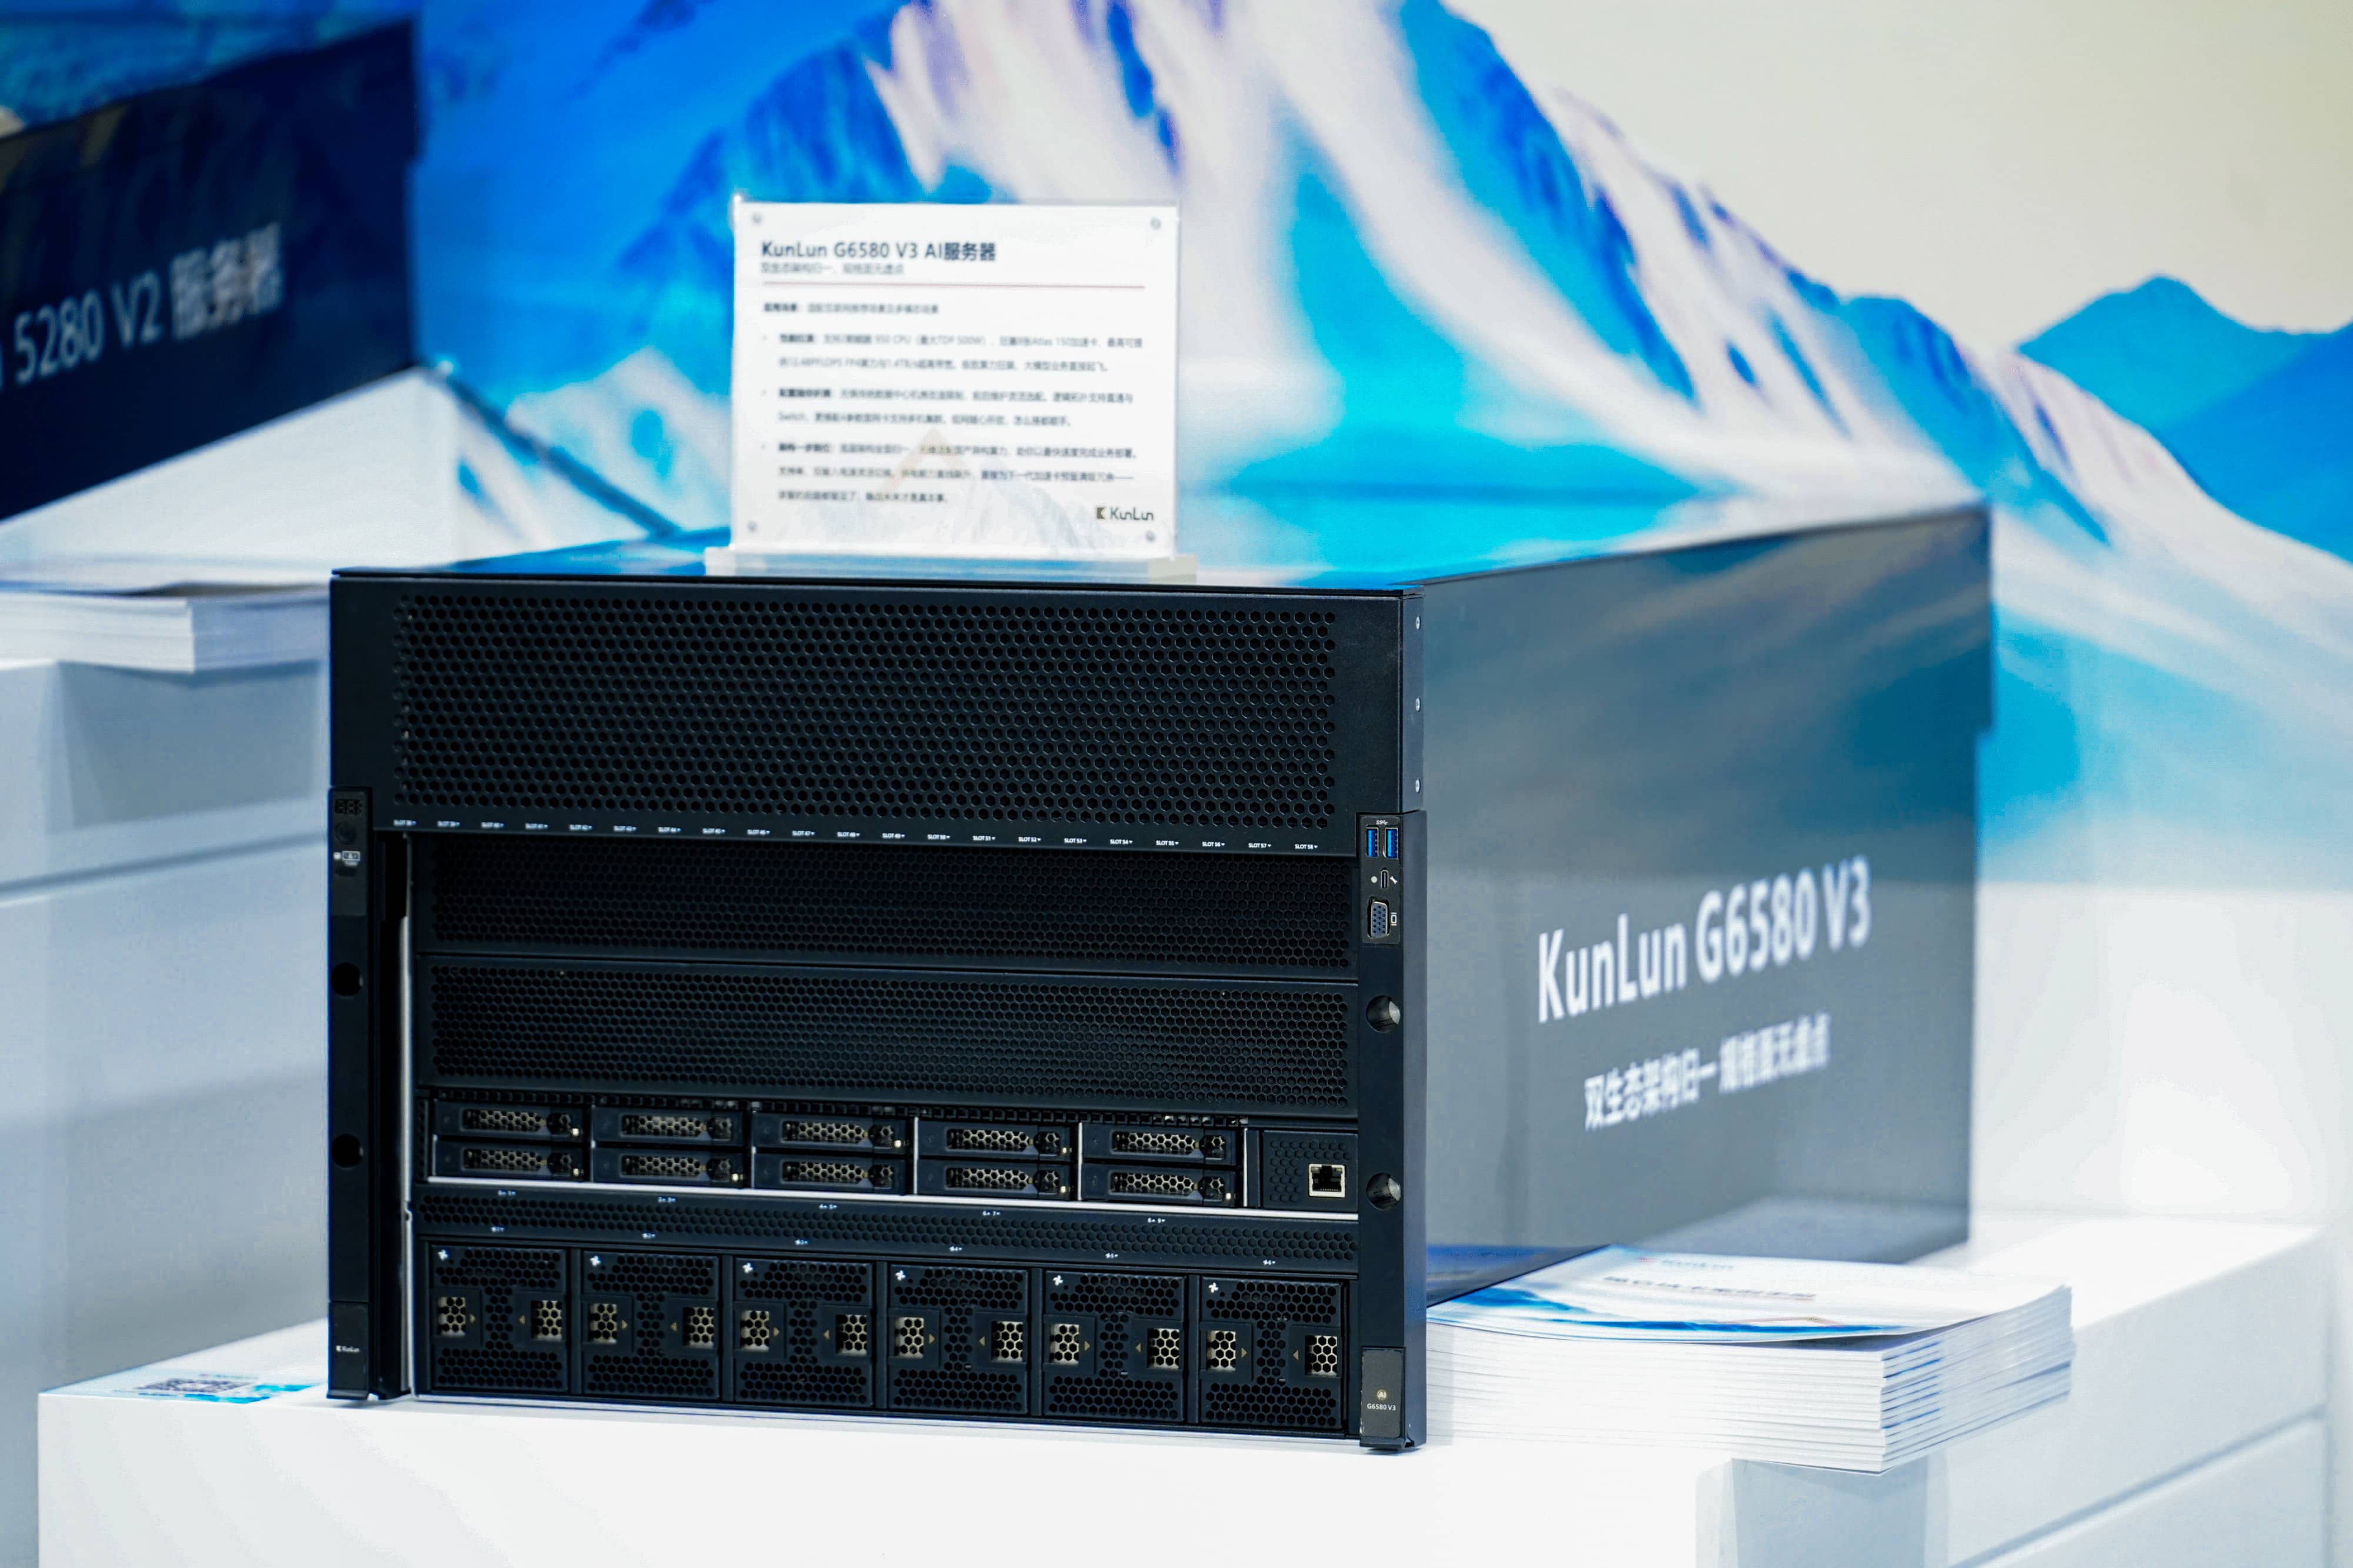
强悍的计算性能:搭载 2 颗鲲鹏 950 处理器。最大支持 8 张 Atlas 150 加速卡,单机即可提供 12.48 PFLOPS@mxFP4 AI算力。同时配备最大 8*112GB 的片上内存与高达 1.4TB/s 的带宽,能够轻松应对大语言模型的高并发推理需求。
领先的归一架构:作为开放生态的坚定践行者,G6580 V3 不仅完美适配昇腾生态,其底层架构实现了高度归一化。 在标准风冷环境下,系统支持 8 张 600W 标卡,全面兼容并支持遂原、昆仑芯、天数、摩尔线程等主流国芯厂家加速卡。为客户解决算力路径依赖的后顾之忧,真正实现“一机多芯”的无缝切换与适配。
灵活选配的平滑升级:针对传统数据中心改造面临的诸多限制,G6580 V3 提供了极简的工程解法。它灵活选配前后维护模式,并支持 Switch 或直通等灵活的逻辑拓扑,帮助客户在不改变现有机房架构的前提下,快速、低成本地完成 AI 业务的部署与上线。
KunLunPoD for AI:新一代液冷超节点,重塑超大规模智算集群巅峰
对于万亿参数大模型训练而言,单机算力已触及物理天花板,构建高效、高密的大规模智算集群成为行业必然选择。
昆仑技术在超节点领域有着深厚的积累。基于上一代围绕 A3 模组打造集群的成功经验,我们迎来了全面的技术升维,从 A3 向 A5 转化的新一代 KunLunPoD for AI 液冷超节点,以更强悍的集群性能和更优的 PUE 表现,重新定义了大规模智算建设的标准。
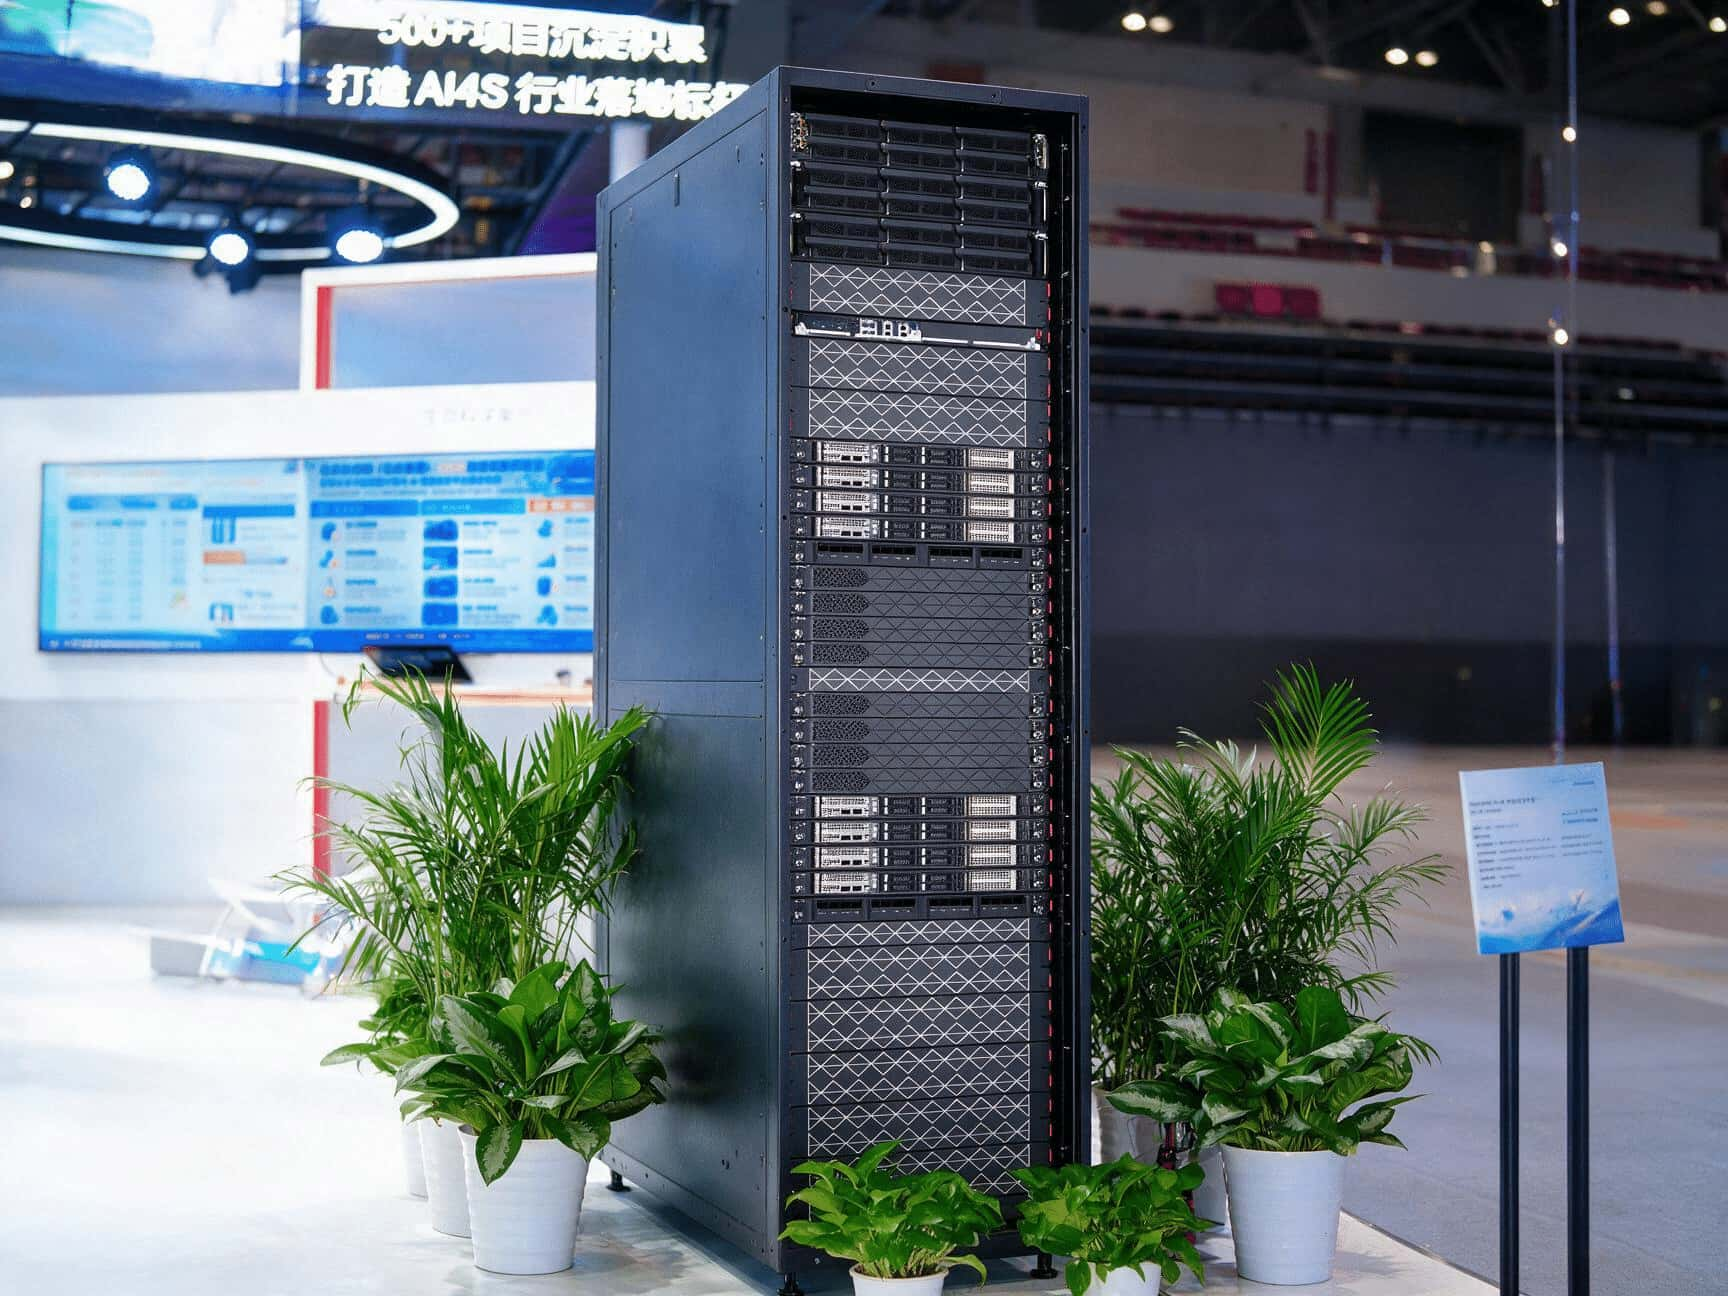
柜级正交架构的高密设计:
● 计算和互联模块化,供电和液冷二总线盲插设计
● 单柜全电互联,支持64卡超节点
● TPSU电源集中式爆发供电
业界极大规模的超节点:
● 提供1 EFLOPS FP8/2 EFLOPS FP4超强算力
● 最大支持1024卡NPU高速互联,总带宽高达1.72PB/s
● 支持百TB级内存统一编址
超高可靠和极简部署
● 灵衢组网链路闪断自恢复,传输层重传,降lane不断业务
● 跨柜全光互联,支持2+2光路保护
● 标准化机柜,整柜交付,满足常规液冷DC机房标准
从风冷标卡服务器 KunLun G6580 V3,到面向大规模协同计算的 KunLunPoD for AI 液冷超节点,昆仑技术将继续围绕不同业务负载和部署条件,完善国产智算基础设施产品的适配与交付能力,与行业伙伴共同支持企业 AI 应用建设。